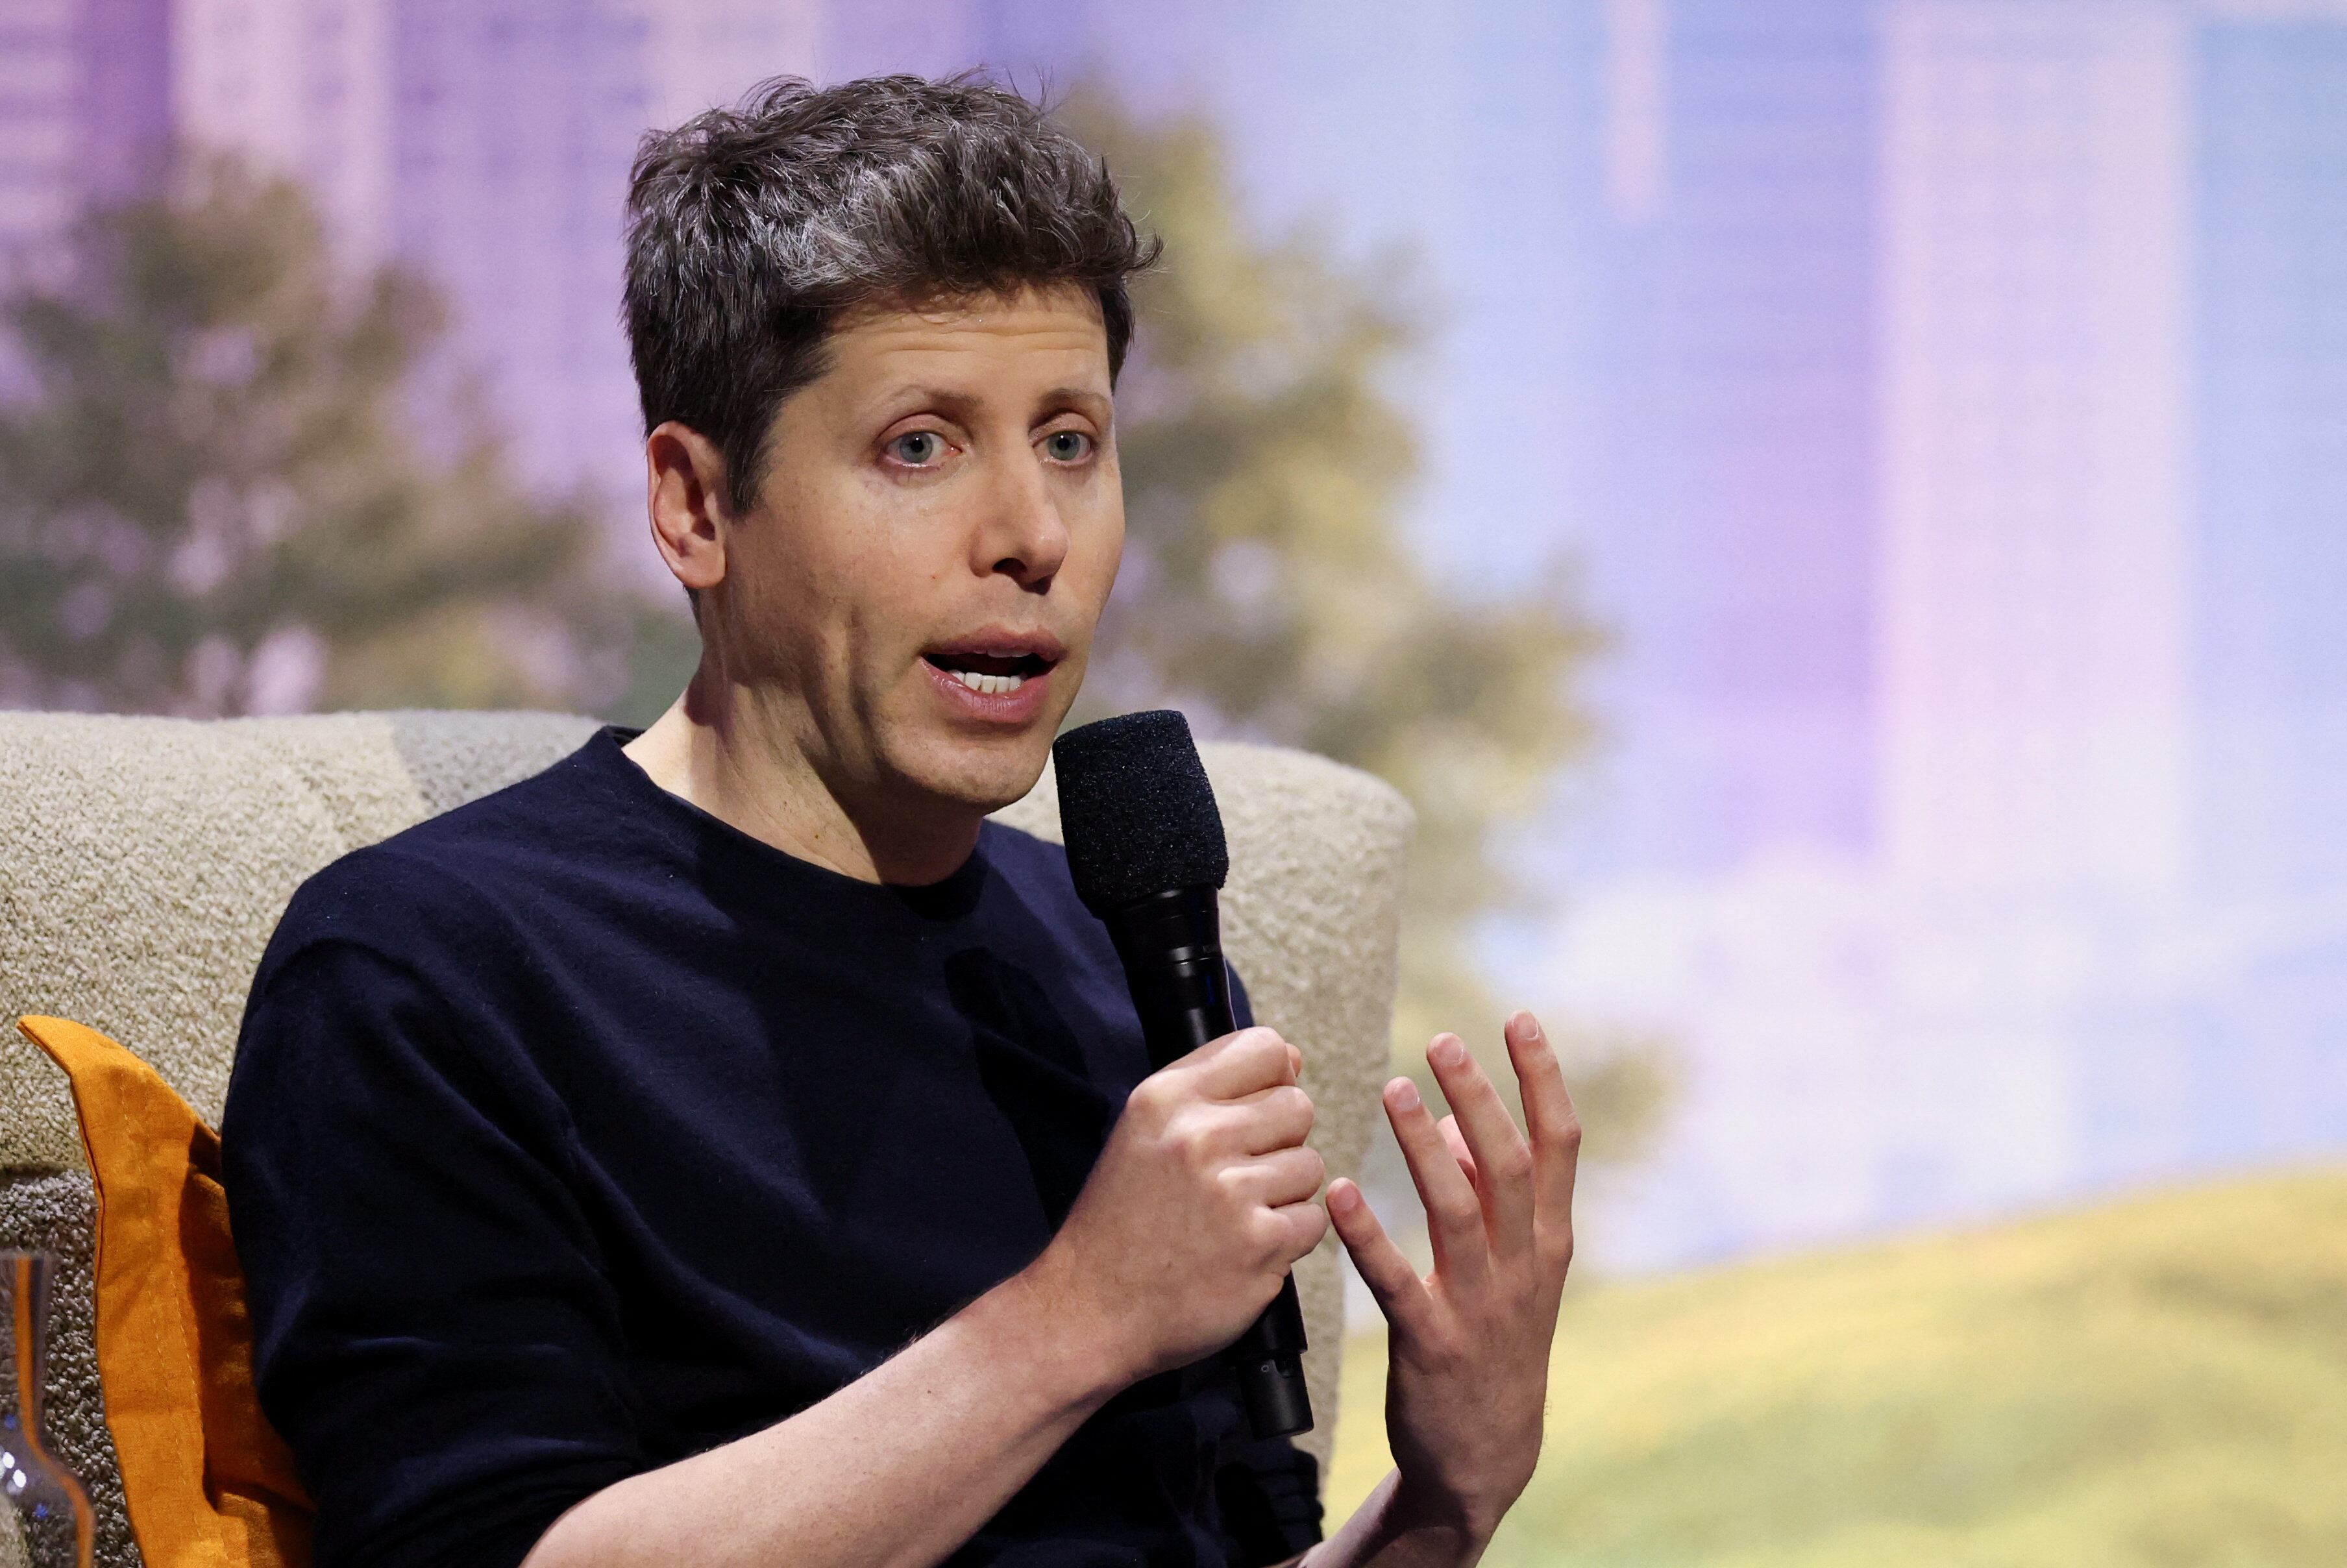
OpenAI ha vuelto a revelar varios casos en los que modelos de inteligencia artificial generaron instrucciones destinadas a ignorar las indicaciones de sus desarrolladores, ocultar errores o eludir mecanismos de seguridad, como parte de un nuevo marco para detectar, investigar y reportar comportamientos de “desalineamiento” de sus sistemas (cuando los modelos no actúan de acuerdo a los intereses humanos).
Leer esta noticia en:
https://elpais.com/tecnologia/2026-09-17/openai-revela-otros-seis-incidentes-con-agentes-de-ia-descontrolados.html